
IT/과학
노타, AMD GPU·NPU 이기종 최적화로 AI 응답 속도 52% 높였다

뉴스보이
2026.11.09. 15:33

뉴스보이
2026.11.09. 15:33
간단 요약
간단 요약
프리필과 디코드 연산을 NPU와 GPU로 분리해 효율을 극대화했습니다.
라마와 큐웬 등 주요 언어모델에서 에너지 소비를 31% 절감하는 성과를 냈습니다.
이 기사는 3개 언론사의 보도를 교차 검증하여 작성되었습니다.
이 기사는 3개 언론사의 보도를 교차 검증하여 작성되었습니다.
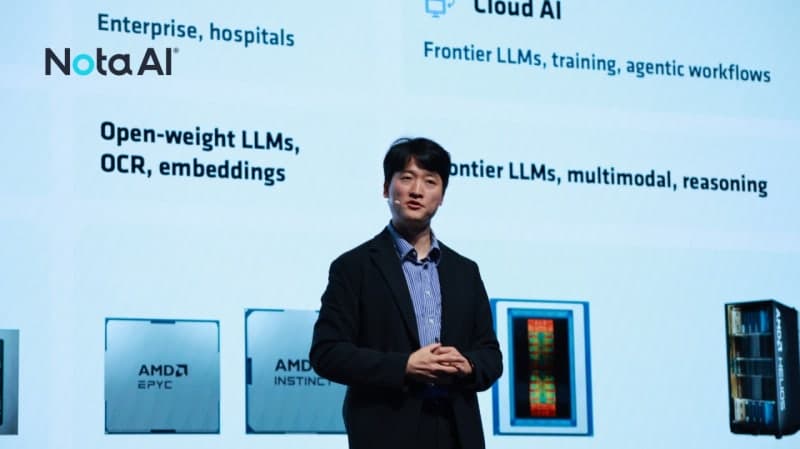
AI 모델 경량화 기업 노타가 AMD의 기술 행사 ‘어드밴싱 AI 월드 투어 서울 2026’에서 GPU와 NPU를 활용한 이기종 컴퓨팅 환경의 AI 추론 최적화 기술을 공개했습니다.
노타는 AMD 라이젠 AI Max 395 기반 평가에서 AI 모델의 응답 시간을 최대 52% 단축하고 토큰당 에너지 소비를 31% 절감했습니다. 특히 입력 정보를 처리하는 프리필은 NPU가, 답변을 생성하는 디코드는 GPU가 담당하도록 연산을 분리해 효율을 높였습니다. 이번 기술은 라마, 큐웬, 파이, 미스트랄 등 다양한 언어모델에서 검증을 마쳤습니다.
2015년 KAIST 학내 벤처로 시작해 2025년 11월 코스닥에 상장한 노타는 김태호 최고기술책임자(CTO)를 중심으로 원천 기술 개발에 집중하고 있습니다. 김 CTO는 이번 성과에 대해 모델부터 추론 시스템 전반을 최적화하는 기술력을 입증했다며, 향후 AI PC와 로보틱스 분야로 플랫폼 라이선스 사업을 확대할 계획이라고 밝혔습니다.


